初识Transformer
Transformer
What Transformer?
Transformer 是以 attention 为核心的一种模型架构,用 attention 机制替代了 RNN ,从而打破了RNN 的时序依赖,不仅训练效果好,还实现了并行训练,大大减少了训练时间。

Transformer 架构图
What Input?
Input 是一个经过 Embedding 之后的向量,Embedding 包含 Word Embedding 和 Position Embedding 其中 Word Embedding 用来捕捉单词之间的语义关系,Position Embedding 用来表示单词间的位置关系。
Word Embedding:
Word Embedding 有很多种方式可以获取,例如可以采用 Word2Vec、Glove 等算法预训练得到,也可以在 Transformer 中训练得到。

word embedding token -> hidden_dim图示
上图很形象的展示了 word embedding 是如何捕捉语义关系的,即每个维度都表示与一个属性的相关度。
以 token cat为例
- 猫是个生命体,所以living being维度的value较高,0.6
- 猫和猫科动物的吻合度更高,所以feline维度的value更高,有0.9(作者提到此处是归一化后的结果,即要保证每个维度的相关度都在-1~+1之间,避免数值过大梯度爆炸)
- 猫和皇族没什么关系,所以royalty维度的value就很低,只有-0.7
由此可见维度越高的输入向量,能表达的信息也越丰富。
position embedding:
由于 Transformer 不采用 RNN 的结构,其自注意力机制本身不包含顺序概念,需要人为注入位置信息。生成一个与 Word Embedding 维度相同的位置向量 PE,表示该单词在序列中的绝对或相对位置。
PE 可以通过训练得到,也可以使用某种公式计算得到。在 Transformer 中采用了后者,计算公式如下:
$$
PE_{(pos,2i)} = \sin \left( \frac{pos}{10000^{2i/d}} \right)
$$
$$
PE_{(pos,2i+1)} = \cos \left( \frac{pos}{10000^{2i/d}} \right)
$$
其中,pos 表示单词在句子中的位置,d 表示 PE的维度 (与词 Embedding 一样),2i 表示偶数的维度,2i+1 表示奇数维度 (即 2i≤d, 2i+1≤d)。
使用这种公式计算 PE 有以下的好处:
- 使 PE 能够适应比训练集里面所有句子更长的句子,假设训练集里面最长的句子是有 20 个单词,突然来了一个长度为 21 的句子,则使用公式计算的方法可以计算出第 21 位的 Embedding。
- 可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。
将单词的词 Word Embedding 和 Position Embedding 相加,就可以得到单词的表示向量 x,x 就是 Transformer 的 Input。
Input → QKV GEMM
What Q/K/V?
- Query(Q,查询向量):当前 token “想要找什么” 的特征表达;
- Key(K,键向量):其他 token “能提供什么” 的特征表达;
- Value(V,值向量):其他 token “实际包含的语义信息”;
而我们此前得到的 Input 是通用向量,需要分别通过与三个权重矩阵 Wq、Wk、Wv进行矩阵乘法转换成对应分工的专用向量,此步是为注意力机制做准备,Self-Attention 的核心逻辑是 “每个 token 作为查询者(Q),去匹配其他 token 的被查询者(K),并提取对应 token 的价值(V)”,以此计算 token 间的注意力关联。
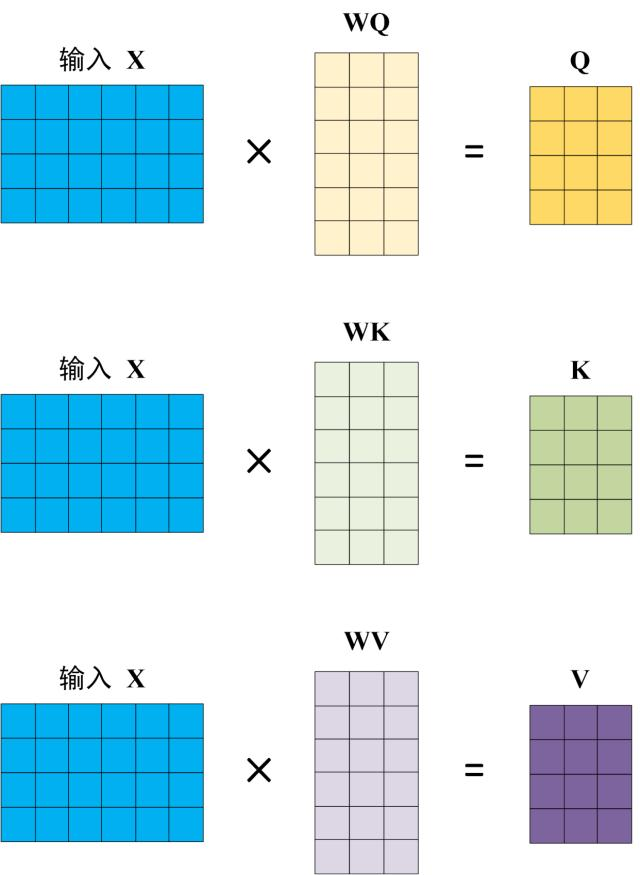
至此 attention 的输入也准备完毕
What Attention?
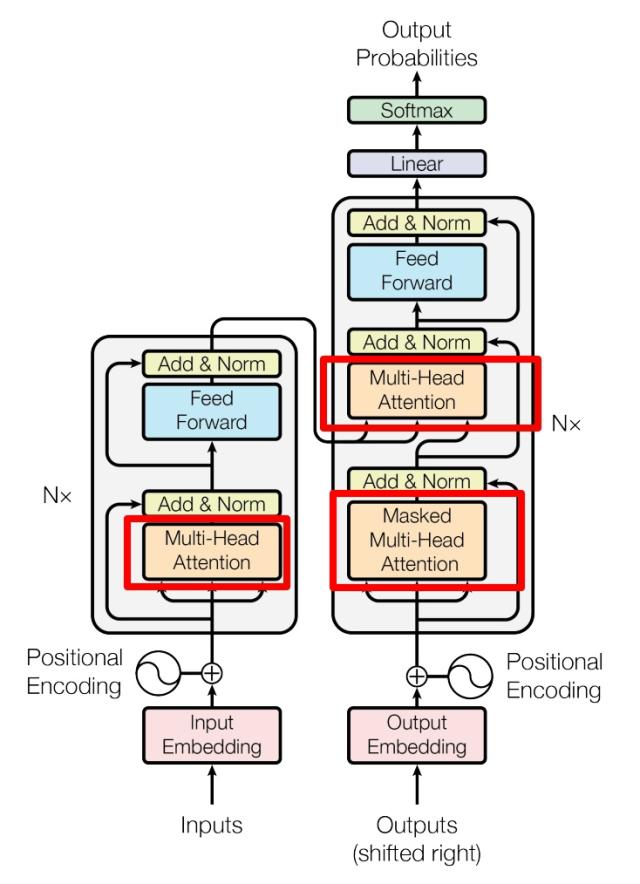
回到 Transformer 的内部结构图,左侧为 Encoder block,右侧为 Decoder block。红色圈中的部分为 Multi-Head Attention,是由多个 Self-Attention 组成的,可以看到 Encoder block 包含一个 Multi-Head Attention,而 Decoder block 包含两个 Multi-Head Attention (其中有一个用到 Masked)。Multi-Head Attention 上方还包括一个 Add & Norm 层,Add 表示残差连接 (Residual Connection) 用于防止网络退化,Norm 表示 Layer Normalization,用于对每一层的激活值进行归一化。
其中 Self-Attention 是 Transformer 的重点,接下来将详细介绍
What Self-Attention?
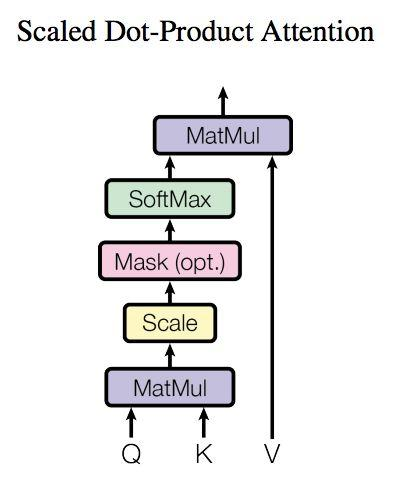
Self-Attention 结构
计算公式如下:
$$
Attention(Q, K, V) = softmax \left(\frac{QK^T}{\sqrt{d_k}}\right)V
$$
$$
其中{d_k}是Q,K矩阵的列数,即向量维度
$$
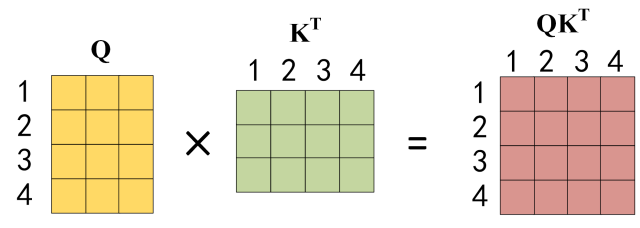
公式中计算矩阵 $Q$ 和 $K^T$ 每一行向量的内积。$Q$ 乘以 $K$ 的转置后,得到的矩阵行列数都为 n,n 为句子单词数,这个矩阵可以表示单词之间的 attention 强度。下图为 $Q$ 乘以 $K^T$,1234 表示的是句子中的单词。
在【经典精读】万字长文解读Transformer模型和Attention机制 提到
为什么有缩放因子$\frac{1}{\sqrt{d_k}}$?
先一句话回答这个问题: 缩放因子的作用是归一化。
假设 $Q$ , $K$ 里的元素的均值为0,方差为1,那么 $A^T = Q^TK$ 中元素的均值为0,方差为 d. 当 d 变得很大时,$A$ 中的元素的方差也会变得很大,如果 $A$ 中的元素方差很大,那么 $softmax(A)$ 的分布会趋于陡峭(分布的方差大,分布集中在绝对值大的区域)。总结一下就是$softmax(A)$ 的分布会和 d 有关。因此 $A$ 中每一个元素乘上 $\frac{1}{\sqrt{d_k}}$ 后,方差又变为1。这使得 $softmax(A)$ 的分布“陡峭”程度与 d 解耦,从而使得训练过程中梯度值保持稳定。
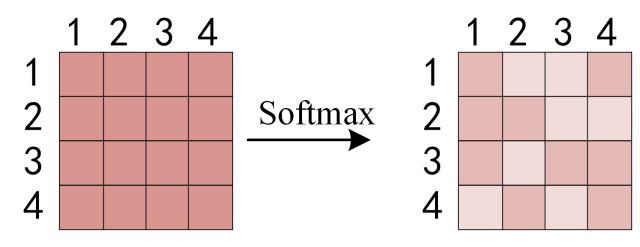
得到 $QK^T$ 之后,使用 Softmax 计算每一个单词对于其他单词的 attention 系数,公式中的 Softmax 是对矩阵的每一行进行 Softmax,即每一行的和都变为 1.
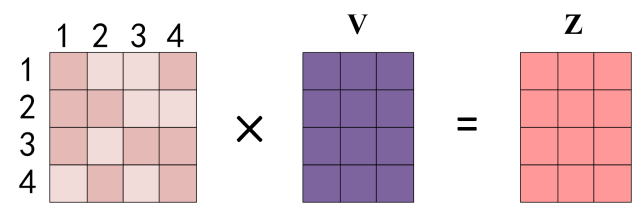
得到 Softmax 矩阵之后可以和V相乘,得到最终的输出Z
Attention的作用
query对应的是需要被表达的序列(称为序列A),key和value对应的是用来表达A的序列(称为序列B)。序列A和序列B在高维空间 $α$ 中的高维表达 A
α的每个位置分别和 Bα计算相似度,产生的权重作用于序列B在高维空间 $β$ 中的高维表达 Bβ,获得序列A在高维空间 $β$ 中的高维表达 Aβ
Encoder部分中只存在self-attention,而Decoder部分中存在self-attention和cross-attention
【self-attention】encoder中的self-attention的query, key, value都对应了源端序列(即A和B是同一序列),decoder中的self-attention的query, key, value都对应了目标端序列。
【cross-attention】decoder中的cross-attention的query对应了目标端序列,key, value对应了源端序列(每一层中的cross-attention用的都是encoder的最终输出)
Multi-head Attention
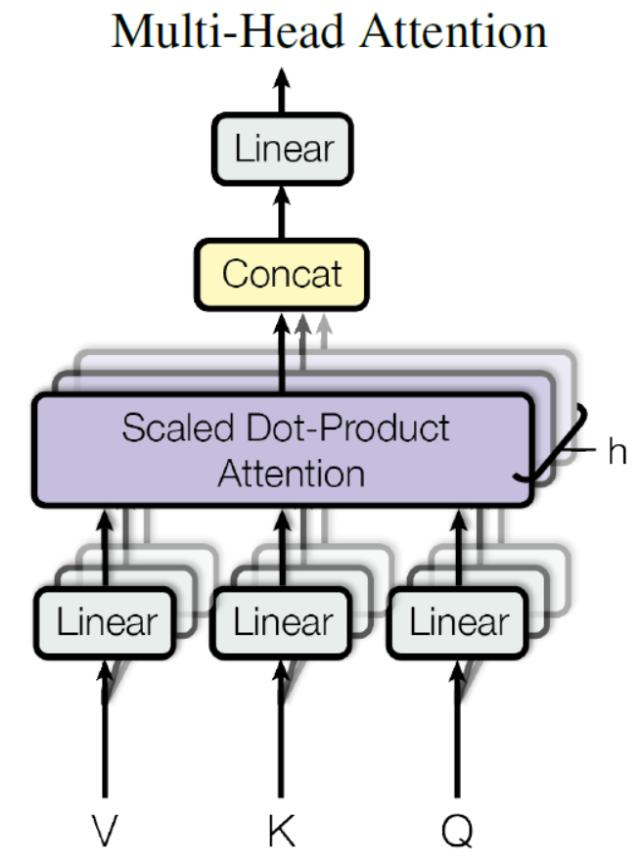
至此我们已经了解了 Self-Attention 的工作原理,而 Multi-Head Attention 是由多个 Self-Attention 组合形成的,下图是论文中 Multi-Head Attention 的结构图。
Multi-Head Attention 结构
为什么要做 Multi-head Attention?
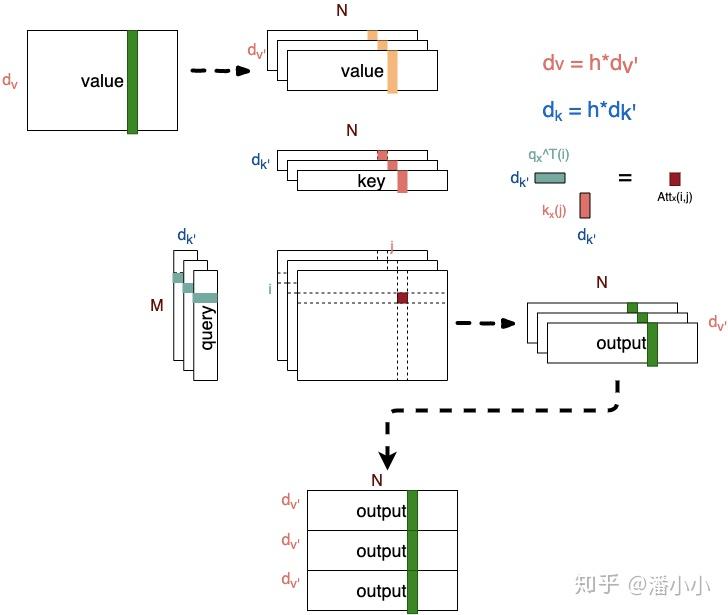
Multi-head Attention 是把 Q、K、V 切分到不同的子空间进行计算,可以在总参数量量级相近的情况下,从不同角度寻找序列关联性,最后再把不同子空间的输出拼接并投影,将捕获到的关系综合起来。
从上图可以看出,qi 和 kj 之间的 attention score 从 1 个变成了 h 个,这就对应了 h 个子空间中它们的关联度。
Masked Multi-head Attention
可以发现 Decoder 端的 Attention 还增加了Mask功能,这是因为Transformer模型属于自回归模型,也就是说后面的token的推断是基于前面的token的。Decoder端的Mask的功能是为了保证训练阶段和推理阶段的一致性。
在推理阶段,token是按照从左往右的顺序推理的。也就是说,在推理timestep=T的token时,decoder只能“看到”timestep < T的 T-1 个Token, 不能和timestep大于它自身的token做attention(因为根本还不知道后面的token是什么)。为了保证训练时和推理时的一致性,所以,训练时要同样防止token与它之后的token去做attention。
What others?
Add & Layer Norm
可以看到传统的 Transformer 模型中,每次 Attention 后都是 Add & Layer Norm。
其中 Add 是残差连接,即用输入 X 加上当前块的输出,从而缓解梯度消失,layer norm则是通过标准化使数据分布具有统一的均值和方差,从而提升模型收敛速度。
公式如下:
$$
LayerNorm(X + \text{MultiHeadAttention}(X))
$$
$$
LayerNorm(X + \text{FeedForward}(X))
$$
Feed Forward Network
经过 attention 之后,会有一个FFN,FFN包含了2层linear transformation层,第一层的激活函数为 Relu,第二层不使用激活函数。
公式如下:
$$
FFN(x) = max(0,xW_1 + b_1)W_2 + b_2
$$
为什么要做这一步?
引入非线性函数,加强模型的表达能力。
Encoder
正如 Transformer 架构图所示 Encoder 部分的 由一个 attention 层和一个 FFN 层组成,并且可以看到 Q/K/V 均来自输入 X
Decoder
与 Encoder 不同的是,Decoder部分有两个 attention 层和一个 FFN 层,第一个 attention 层的输入均来自 output,第二个 attention 层其实是cross-attention,即 K/V来自 Encoder 的输出,Q 则来自第一个 attention 层的输出。
可以理解成 Decoder 去检索 Encoder 的内容。
最后输出层则是在经过 FFN 层后做一次 Linear 变换 + softmax 归一化,转换成概率并输出。
相关链接:
【经典精读】万字长文解读Transformer模型和Attention机制
Transformer 可视化工作流程:Transformer Explainer: LLM Transformer Model Visually Explained